Datenengpässe bremsen Ihr Unternehmen: Sollten Sie ein Data Mesh oder Data Fabric aufbauen?
Wichtige Highlights:
- Mit dem Wachstum von Datenteams, Systemen und Domänen werden fragmentierte Daten und überlastete zentrale Teams zu geschäftlichen Engpässen. Dadurch wird der Zugriff auf verlässliche Daten verlangsamt und Entscheidungen werden verzögert.
- Das Verständnis von Data Mesh im Vergleich zu Data Fabric hilft dabei festzustellen, ob das zentrale Problem bei Datenverantwortung, Auffindbarkeit, Integration oder Governance liegt, sodass Investitionen gezielt auf den tatsächlichen Engpass ausgerichtet werden können.
- Die richtige Lösung besteht selten allein in der Wahl eines Frameworks. Data Mesh, Data Fabric, Governance, Integration und Analytics-Funktionen müssen zusammenspielen, um eine skalierbare und nutzbare Datenumgebung zu schaffen.
- Sigmas BI- & Analytics-Development-Services vereinen Data Engineering, moderne Datenarchitektur, Business Intelligence, Analytics, Integration und Governance, um den Engpass zu diagnostizieren, die passende Architektur zu entwickeln und diese schrittweise umzusetzen.
Einleitung
Das Symptom ist immer dasselbe. Ein Produktmanager benötigt einen Datensatz, der mit einem anderen Datensatz verknüpft werden soll. Die Anfrage geht an das zentrale Datenteam, das bereits drei Sprints tief in einem Backlog steckt, sodass sie erst in der siebten Woche bearbeitet wird. Bis dahin hat sich die ursprüngliche Fragestellung möglicherweise geändert oder die Entscheidung wurde bereits ohne diese Daten getroffen. Übertragen Sie dieses Szenario auf acht Domänen und vierzig Stakeholder, entsteht ein Unternehmen, in dem Daten zwar vorhanden und weitgehend sauber sind, aber dennoch nicht mit der Geschwindigkeit genutzt werden können, mit der sich das Geschäft bewegt.
An diesem Punkt teilt häufig jemand einen Artikel über Data Mesh im Vergleich zu Data Fabric, und die Diskussion entwickelt sich zu einer Architekturdebatte, bevor überhaupt jemand den tatsächlichen Engpass diagnostiziert hat. Sigmas BI- & Analytics-Development-Services unterstützen Datenverantwortliche in Unternehmen dabei, zunächst diese Diagnose durchzuführen und das Ergebnis anschließend schrittweise umzusetzen, anstatt alles auf eine einzige große Investition zu setzen.
Die beiden Ansätze lösen tatsächlich unterschiedliche Probleme. Die Entscheidung zwischen ihnen hängt weniger von technologischen Präferenzen ab als von einer ehrlichen Einschätzung darüber, an welcher Stelle Ihre Organisation tatsächlich scheitert.
Verlangsamen Datenengpässe Ihre Entscheidungen?
Was die beiden Ansätze tatsächlich vorschlage
Data mesh ist eine organisatorische Antwort. Der Ansatz geht davon aus, dass das zentrale Datenteam einen strukturellen Engpass darstellt und dass die Lösung darin besteht, die Verantwortung auf die Domänen zu verteilen, die die Daten erzeugen. Jede Domäne behandelt ihre Daten als Produkt – mit einem Verantwortlichen, dokumentierten Schnittstellen, Qualitätsgarantien und klar definierten Nutzern, gegenüber denen sie verantwortlich ist. Ein zentrales Plattformteam stellt Self-Service-Infrastruktur bereit, während eine föderierte Governance die Standards definiert, die von allen eingehalten werden.
Data Fabric ist eine technische Antwort. Der Ansatz geht davon aus, dass die Fragmentierung über verschiedene Systeme hinweg das eigentliche Problem darstellt. Die Lösung besteht in einer einheitlichen Ebene aus Metadaten, Katalogisierung und automatisierter Integration, über die Nutzer Daten unabhängig von ihrem Speicherort finden und darauf zugreifen können. Die Verantwortlichkeiten bleiben weitgehend unverändert. Die Intelligenz wird in die Metadatenebene verlagert, wobei zunehmend Machine Learning eingesetzt wird, um Beziehungen abzuleiten und Integrationsaufgaben zu automatisieren, die zuvor manuell von Entwicklern durchgeführt wurden.
Der entscheidende Unterschied: Mesh verändert, wer verantwortlich ist; Fabric verändert, wie Systeme miteinander verbunden werden.
| Dimension | Data Mesh | Data Fabric |
| Grundlegender Ansatz | Änderung des Betriebsmodells und der Verantwortlichkeiten | Technologie- und Metadatenebene |
| Gelöstes Kernproblem | Das zentrale Team ist ein Bereitstellungsengpass | Daten sind fragmentiert und schwer auffindbar |
| Verantwortung | Auf Domänenteams verteilt | Weitgehend unverändert, häufig zentralisiert |
| Voraussetzung | Domänenteams mit Data-Engineering-Kompetenz | Umfassende Metadaten- und Katalogabdeckung |
| Governance-Modell | Föderiert, mit zentral vereinbarten Standards | Zentralisierte Richtlinien, die quellenübergreifend angewendet werden |
| Häufigste Fehlerursache | Domänen verfügen nicht über die Fähigkeiten oder Anreize, Datenprodukte zu verantworten | Plattform wird implementiert, aber nicht angenommen |
| Zeit bis zum ersten Mehrwert | Langsam, da organisatorische Veränderungen erforderlich sind | Schneller durch schrittweise technische Einführung |
Die diagnostische Frage, die die meisten Teams überspringen
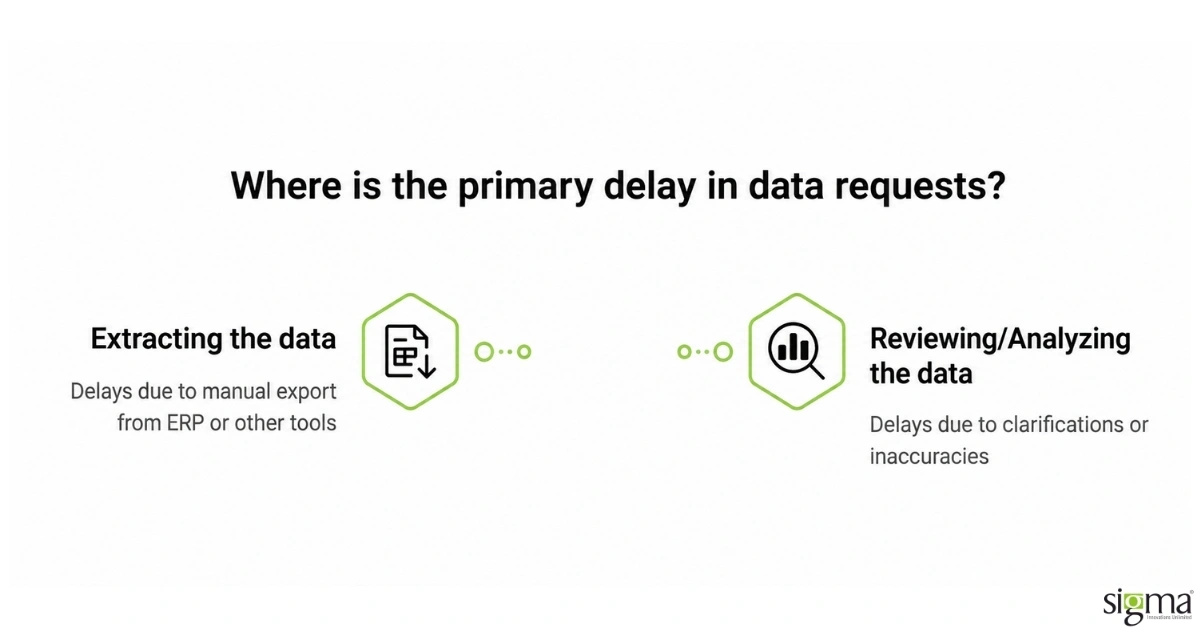
Bevor Sie die beiden Ansätze vergleichen, beantworten Sie eine Frage ehrlich: Wenn eine Datenanfrage zu lange dauert, wo entsteht die Verzögerung tatsächlich?
Wenn die Verzögerung dadurch entsteht, dass ein kleines zentrales Team überlastet ist und Domänenexperten in einer Warteschlange auf Personen warten, die die Daten weniger gut verstehen als sie selbst, handelt es sich um ein Verantwortungsproblem. Zusätzliche Tools lösen keine Warteschlange. Eine Data-Mesh-Architektur adressiert dieses Problem, indem die Arbeit zu den Personen verlagert wird, die über den entsprechenden Kontext verfügen.
Wenn die Verzögerung dadurch entsteht, dass Mitarbeiter vorhandene Daten nicht finden können, nicht wissen, ob ein Datensatz vertrauenswürdig ist, oder mehrere Tage damit verbringen, drei Systeme abzugleichen, die dieselbe Entität unterschiedlich beschreiben, handelt es sich um ein Problem der Auffindbarkeit und Integration. Eine Verteilung der Verantwortlichkeiten löst dieses Problem nicht und kann es sogar verschärfen, da nun acht Teams unabhängig voneinander Datensätze erstellen, die niemand finden kann. Eine Data-Fabric-Architektur löst dieses Problem, indem sie die gesamte Datenlandschaft navigierbar macht.
Die meisten Unternehmen weisen Elemente beider Probleme auf. Entscheidend ist, welcher Engpass aktuell die stärkste Einschränkung darstellt, denn davon hängt ab, wohin die erste Investition fließen sollte.
Wenn Ihre Diagnose auf Fragmentierung hindeutet, erfahren Sie hier, wie die Integrationsmechanismen tatsächlich funktionieren: ETL-Pipelines als Schlüssel zur Lösung von Datenfragmentierung.
Wo Data Mesh scheitert
Data Mesh scheitert auf vorhersehbare Weise, und es ist wichtig, diese Ursachen klar zu benennen, da ein Scheitern kostspielig ist.
Das Modell setzt voraus, dass Domänenteams Datenprodukte eigenständig verantworten können. Das bedeutet beispielsweise, dass jemand im Marketing Pipelines entwickelt und wartet, SLAs definiert, Support für Datennutzer leistet und die Qualität überwacht. Viele Domänenteams verfügen weder über diese Fähigkeiten noch über die personellen Ressourcen, sie aufzubauen. Die Verantwortung wird in einer Präsentation neu verteilt, tatsächlich ändert sich jedoch wenig – außer dass das zentrale Team weniger Befugnisse besitzt, Probleme zu beheben, für die es weiterhin verantwortlich gemacht wird.
Die zweite Fehlerquelle besteht darin, die Self-Service-Plattform zu überspringen. Data Mesh ohne tatsächlich nutzbare gemeinsame Infrastruktur ist lediglich Dezentralisierung und führt zu mehreren inkompatiblen Pipelines ohne wirksame Governance.
Der dritte Fehler besteht darin, föderierte Governance als optional zu betrachten. Ohne gemeinsam vereinbarte Interoperabilitätsstandards erzeugen Domänen Datenprodukte, die sich nicht miteinander verbinden lassen. Dadurch wird die ursprüngliche Fragmentierung lediglich mit mehr Verantwortlichen neu geschaffen.
Wo Data Fabric scheitert
Data Fabric scheitert auf andere Weise. Die Technologie wird implementiert, aber niemand nutzt sie.
Ein Datenkatalog ist nur dann wertvoll, wenn er umfassend und aktuell ist. Bei unvollständiger Abdeckung suchen Nutzer darin, finden nicht, was sie benötigen, und verwenden den Katalog anschließend nicht mehr. Veraltete Metadaten können sogar problematischer sein als fehlende Metadaten, da sie überzeugend wirkende, aber falsche Informationen über Data Lineage und Verantwortlichkeiten liefern.
Datenarchitekturstil in Data Fabric investieren und nur einen begrenzten Nutzen erzielen, häufig ein Verantwortungsproblem, das sie fälschlicherweise als Auffindbarkeitsproblem diagnostiziert haben.
Die Kombination, für die sich die meisten Unternehmen entscheiden
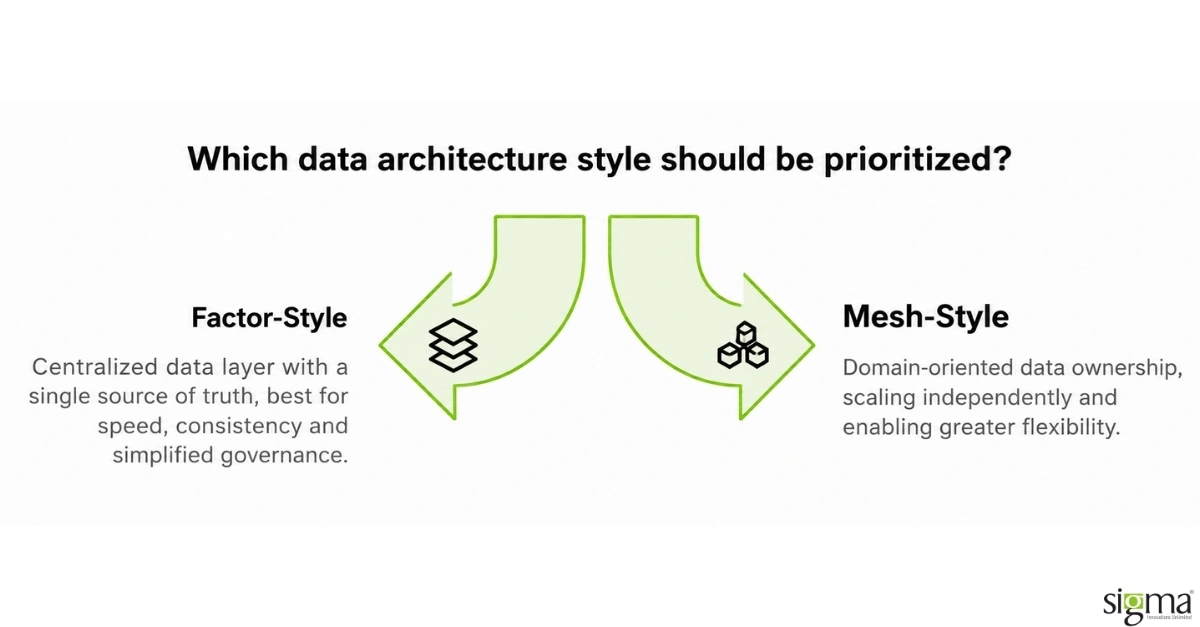
In der Praxis ist die strikte Entweder-oder-Betrachtung eher ein theoretisches Konstrukt. Große Unternehmen setzen häufig Technologien im Stil von Data Fabric ein – einschließlich umfassender Katalogisierung, automatisierter Data Lineage und einheitlichem Datenzugriff – und wenden gleichzeitig Data-Mesh-basierte Verantwortungsmodelle gezielt in den Domänen an, die dazu organisatorisch in der Lage sind.
Dieser hybride Ansatz funktioniert, weil sich beide Konzepte nicht widersprechen. Eine Domäne, die ein Datenprodukt veröffentlicht, benötigt Nutzer, die es finden können – ein Data-Fabric-Thema. Ein Katalog wiederum benötigt für jeden Eintrag einen klaren Verantwortlichen – ein Data-Mesh-Thema. Die Bei der Entscheidung über die Datenarchitektur geht es weniger darum, „welcher Ansatz“, sondern vielmehr darum, „welcher zuerst und in welchem Umfang“.
Bei der Reihenfolge werden häufig zunächst Data-Fabric-orientierte Grundlagen bevorzugt, da Katalogisierung und Data Lineage schrittweise Mehrwert liefern, ohne organisatorische Veränderungen zu erfordern. Gleichzeitig erleichtern sie die spätere Verteilung von Verantwortlichkeiten erheblich.
Mehr erfahren: Eine BI-Plattform transformiert die Datenanalyse für ein VC-finanziertes Unternehmen aus dem Silicon Valley
Sigmas BI- und Analytics-Ansatz beginnt mit der Datenlandschaft und nicht mit der Bezeichnung einer Architektur.. Anstatt Data Mesh oder Data Fabric als Selbstzweck zu betrachten, entwickelt Sigma die Datenarchitektur auf Grundlage der tatsächlichen Datenherausforderungen, bestehenden Systeme und Geschäftsanforderungen des Unternehmens.
Integrierte Unternehmensdaten für bessere Business Intelligence
Für ein Finanzdienstleistungsunternehmen führte Sigma Kredit-, Servicing-, CRM- und Marketingdaten zusammen in einer kontrollierten, Snowflake-nativen Plattform mit rollenbasiertem Zugriff. Die daraus entstandene Grundlage führte fragmentierte operative Daten zusammen und ermöglichte Echtzeit-Portfolioanalysen sowie einen einfacheren Zugang zu entscheidungsrelevanten Informationen.
Mehr erfahren: Eine Snowflake-native Plattform für Lending Intelligence.
Integrierte Unternehmensdaten für bessere Business Intelligence
Für ein Technologie-Dienstleistungsunternehmen konsolidierte Sigma Daten aus CMDB, Servicekatalog und mehreren führenden Systemen durch gezielt entwickelte Integrationen. Das Projekt zeigt, wie Sigma unterschiedliche Unternehmensdatenquellen miteinander verbindet, um eine strukturiertere Grundlage für Business Intelligence und Analytics zu schaffen.
Zusammen verdeutlichen diese Projekte Sigmas BI- und Analytics-Kompetenzen in den Bereichen Datenintegration, kontrollierte Datenplattformen, rollenbasierter Zugriff und Analytics. Anstatt Data Mesh oder Data Fabric als Selbstzweck zu betrachten, entwickelt Sigma die Datenarchitektur auf Grundlage der tatsächlichen Datenherausforderungen, bestehenden Systeme und Geschäftsanforderungen des Unternehmens.
Mehr erfahren: Eine BI-Plattform transformiert die Datenanalyse für ein VC-finanziertes Unternehmen aus dem Silicon Valley
Fazit
Data Mesh im Vergleich zu Data Fabric ist kein Technologiewettbewerb mit einer einzigen richtigen Antwort. Data Mesh verteilt Verantwortlichkeiten neu, um ein Engpassproblem zu lösen, und setzt Kompetenzen in den einzelnen Domänen voraus, über die viele Unternehmen nicht verfügen. Data Fabric vereinheitlicht Auffindbarkeit und Integration, um ein Fragmentierungsproblem zu lösen, bietet jedoch nur begrenzten Nutzen, wenn niemand für die katalogisierten Daten verantwortlich ist. Unternehmen, die die richtige Entscheidung treffen, beginnen mit einer Diagnose, bestimmen, ob Verantwortlichkeit oder Auffindbarkeit den entscheidenden Engpass darstellt, und legen anschließend die passende Reihenfolge fest. Häufig beginnen sie mit Grundlagen, die bereits Mehrwert schaffen, ohne eine organisatorische Umstrukturierung zu erfordern. Sigma Infosolutions unterstützt Datenverantwortliche in Unternehmen dabei, diese Diagnose realistisch durchzuführen und das Ergebnis schrittweise umzusetzen, anstatt alles auf eine einzige große Investition zu setzen.
Verlangsamen Datenengpässe Ihre Entscheidungen? Sprechen Sie mit Sigmas BI- & Analytics-Experten, um Ihre Datenherausforderungen zu analysieren und die passende Architektur für skalierbare, umsetzbare Erkenntnisse aufzubauen.
Häufig gestellte Fragen
Warum scheitern Data-Mesh-Implementierungen häufig?
Data Mesh ist ein Betriebsmodell, bei dem die Datenverantwortung auf Domänenteams verteilt wird, die Daten als Produkt behandeln. Data Fabric ist eine Technologieschicht, die Metadaten, Katalogisierung und automatisierte Integration nutzt, um den Zugriff auf fragmentierte Systeme zu vereinheitlichen. Mesh verändert, wer verantwortlich ist; Fabric verändert, wie Systeme miteinander verbunden werden.
Data Mesh
Identifizieren Sie zunächst, wo die Verzögerung tatsächlich entsteht. Wenn Domänenexperten aufgrund eines überlasteten zentralen Teams in einer Warteschlange stehen, handelt es sich um ein Verantwortungsproblem, für das sich Data-Mesh-Architektur. Wenn Mitarbeiter Datensätze nicht finden oder ihrer Qualität nicht vertrauen können, handelt es sich um ein Auffindbarkeitsproblem, für das Data Fabric geeignet ist. Die meisten Unternehmen haben beide Problemarten und müssen die Maßnahmen entsprechend priorisieren.
Warum scheitern Data-Mesh-Implementierungen häufig?
Data mesh setzt voraus, dass Domänenteams Datenprodukte entwickeln und pflegen können, wofür Engineering-Kompetenzen erforderlich sind, über die viele Domänen nicht verfügen. Der Ansatz scheitert außerdem, wenn die Self-Service-Plattform übersprungen wird und dadurch unkoordinierte Pipelines entstehen oder wenn föderierte Governance als optional betrachtet wird und dadurch Domänendaten entstehen, die sich nicht miteinander verbinden lassen.
Warum werden Data-Fabric-Plattformen häufig nur wenig genutzt?
Eine unvollständige Katalogabdeckung führt dazu, dass Nutzer nach einigen erfolglosen Suchen aufhören, den Katalog zu verwenden, während veraltete Metadaten irreführende Informationen zur Data Lineage liefern. Eine Data-Fabric-Architektur kann Daten außerdem auffindbar machen, ohne gleichzeitig klare Verantwortlichkeiten zu schaffen. Dadurch verbessert sich zwar die Auffindbarkeit, nicht jedoch das Vertrauen, was den Nutzen der Plattforminvestition begrenzt.
Kann ein Unternehmen sowohl Data Mesh als auch Data Fabric einsetzen?
Ja, und viele Unternehmen tun dies. Data-Fabric-basierte Katalogisierung und Data Lineage schaffen Grundlagen, die schrittweise Mehrwert liefern, ohne organisatorische Veränderungen zu erfordern, während Data Mesh die Datenverantwortung gezielt in den Domänen eingesetzt wird, die über die erforderlichen Fähigkeiten verfügen. Die praktische Bei der praktischen Frage der Datenarchitektur geht es darum, welcher Ansatz zuerst priorisiert werden sollte, anstatt sich ausschließlich für einen der beiden zu entscheiden.