AWS-Cloud-Migration: Was eine fehlerhafte Umsetzung tatsächlich kostet
Die Migration wurde termingerecht abgeschlossen, es gab keine Ausfälle und dennoch ist die monatliche Rechnung höher als die Kosten des zuvor genutzten Rechenzentrums. Dies ist ein typisches Ergebnis einer AWS-Cloud-Migration die als reines Infrastrukturprojekt durchgeführt wurde – und es handelt sich dabei nicht um ein technisches Versagen. Jeder Workload wurde erfolgreich migriert. Was jedoch nicht übertragen wurde, war ein Mechanismus zur Steuerung der Kosten jedes einzelnen Workloads. Dadurch hat das Unternehmen kontrollierte Investitionsausgaben, die zuvor über den Einkauf gesteuert wurden, gegen Betriebsausgaben eingetauscht, die niemand genehmigt, bevor sie entstehen. Die hier beschriebenen Kosten sind keine Migrationskosten. Es sind die Kosten einer Migration, die technisch erfolgreich war, bei der jedoch niemand die Verantwortung für die wirtschaftlichen Auswirkungen übernommen hat.
Die wichtigsten Erkenntnisse
- Führungskräfte, denen Einsparungen zugesagt wurden, erhalten stattdessen eine höhere Rechnung, weil bestehende Ineffizienzen auf eine verbrauchsabhängig abgerechnete Infrastruktur übertragen wurden, ohne klare Verantwortung für die Verbrauchskontrolle zu schaffen.
- Implementieren Sie Kostenkontrollen als konkrete Migrationsergebnisse mit klar benannten Verantwortlichen, anstatt eine spätere Optimierungsphase einzuplanen, die nach einem erfolgreichen Cutover wahrscheinlich an Priorität verliert.
- Cloud-Ausgaben werden zu einem kontrollierten und planbaren Kostenfaktor statt zu einer monatlichen Überraschung, die den Business Case nachträglich schwächt.
- Sigma betrachtet Kosten-Governance als festen Bestandteil des Migrationsumfangs, da gerade die nach Abschluss einer Migration geplante Optimierungsphase besonders häufig gestrichen wird.
Eine AWS-Cloud-Migration ist im Kern ein Kosten-Governance-Projekt im Gewand eines Infrastrukturprojekts
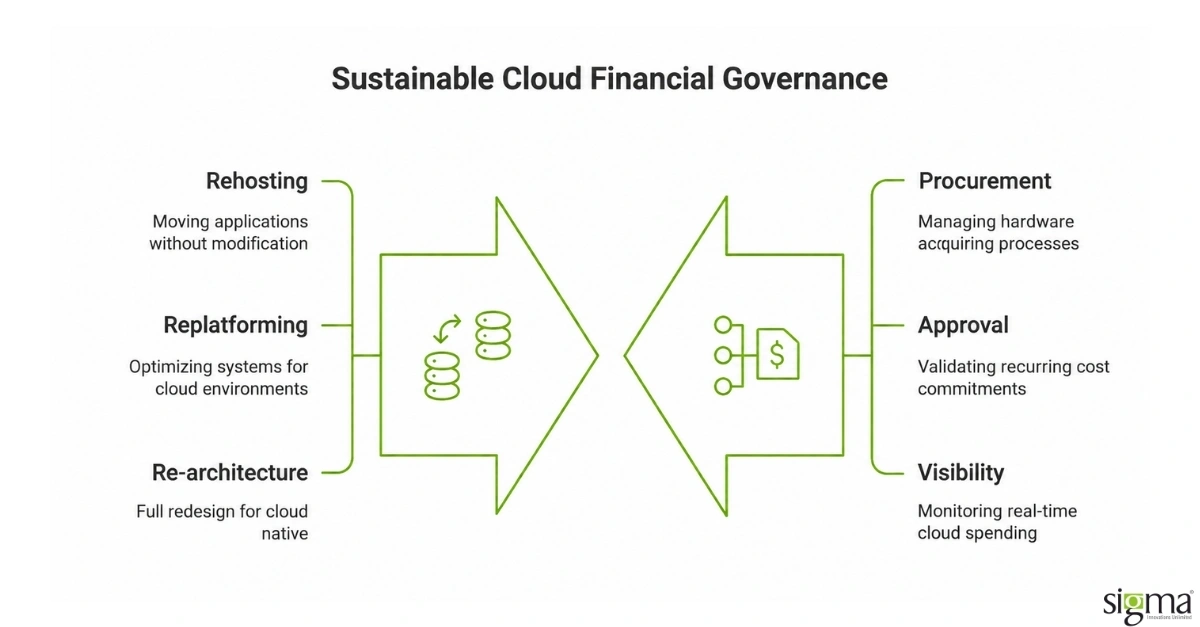
AWS-Cloud-Migration bezeichnet die Verlagerung von Anwendungen, Daten und Infrastruktur aus einer bestehenden Umgebung zu AWS unter Verwendung einer der von AWS in seinen Migrationsrichtlinien beschriebenen Strategien. Diese reichen vom Rehosting ohne Änderungen über Replatforming bis hin zu einer vollständigen Neugestaltung der Architektur. Die technischen Aufgaben sind gut verstanden und zunehmend automatisiert. Entscheidend für den langfristigen Erfolg des Business Case ist jedoch die organisatorische Frage, wer Ausgaben verursachen darf.
On-Premises ist die Bereitstellung zusätzlicher Kapazität ein Beschaffungsvorgang. Jemand fordert Hardware an, jemand genehmigt die Bestellung und ein bereits bestehender Finanzprozess setzt die entsprechenden Grenzen. Bei AWS kann zusätzliche Kapazität dagegen durch einen API-Aufruf bereitgestellt werden. Ein Entwickler, der nachts um zwei Uhr ein berechtigtes Problem löst, kann dadurch wiederkehrende Kosten für das Unternehmen verursachen, ohne dass zuvor eine Genehmigung erforderlich ist – und diese Kosten werden möglicherweise erst Wochen später sichtbar. Eine Migration ohne Ersatz dieses Genehmigungsmechanismus beseitigt eine Kontrolle, deren Bedeutung zuvor kaum noch wahrgenommen wurde. Deshalb können Rechnungen steigen, obwohl jede einzelne Entscheidung für sich genommen nachvollziehbar war.
Fünf Gründe, warum die Kosten nach einer erfolgreichen Migration steigen
Überprovisionierung ist der erste und größte Kostenfaktor. Instanzgrößen werden häufig entsprechend den zu ersetzenden On-Premises-Servern gewählt. Diese Server wurden jedoch möglicherweise für Lastspitzen dimensioniert, die nie eingetreten sind, zusätzlich mit Sicherheitsreserven und aus Sorge vor einer zu geringen Dimensionierung. Diese über Jahre entstandenen Reserven werden unverändert in die Cloud übertragen und anschließend stundenweise abgerechnet.
Datenübertragung ist der zweite Kostenfaktor und für Finanzteams häufig der überraschendste, da es dafür kein direktes On-Premises-Äquivalent gibt. Datenverkehr zwischen Availability Zones, zwischen Regionen und ins Internet wird nutzungsabhängig abgerechnet. Architekturen, die ohne Berücksichtigung dieser Grenzen entwickelt wurden, können daher Kosten verursachen, die in keiner Prognose berücksichtigt wurden. Die entscheidende Kontrollmaßnahme ist eine Architekturprüfung vor dem Cutover statt einer nachträglichen Analyse, da eine spätere Änderung der Datenpfade Änderungen an der Anwendung erfordern kann.
Verwaiste Ressourcen sind der dritte Kostenfaktor. Migrationen erzeugen Testinstanzen, duplizierte Volumes, Snapshots und Load Balancer, und häufig endet das Projekt, bevor geprüft wurde, welche davon weiterhin benötigt werden. Der vierte Faktor ist die schleichende Nutzung ungeeigneter Speicherklassen, bei der sich Logs und Backups unbegrenzt in kostenintensivem Speicher ansammeln, weil keine Lifecycle-Richtlinie definiert wurde. Der fünfte Faktor ist die Lizenzierung und zugleich das größte Einzelrisiko, da bestimmte kommerzielle Lizenzen auf virtualisierter Infrastruktur anderen Bedingungen unterliegen und daraus resultierende Verpflichtungen möglicherweise erst bei einem Audit sichtbar werden.
| Fehlermodus | Warum er auftritt | Kontrollmaßnahme zur Vermeidung | Wann sie implementiert werden sollte |
| Überprovisionierung | Unveränderte Übernahme der On-Premises-Dimensionierung | Nutzungsbasiertes Right-Sizing pro Workload | Während der Wellenplanung, vor dem Cutover |
| Datenübertragungskosten | Zonen- und Regionsgrenzen wurden bei der Architektur nicht berücksichtigt | Architekturprüfung der Datenpfade | Vor dem Cutover, nicht danach |
| Verwaiste Ressourcen | Das Projekt endet vor der abschließenden Bereinigung | Verpflichtendes Tagging mit einem Verantwortlichen pro Ressource | Bei der Einrichtung des Accounts |
| Abweichung bei der Speicherklasse | Keine Lifecycle-Richtlinie definiert | Aufbewahrungsregeln gemeinsam mit dem Workload definieren | Während der Migration dieses Workloads |
| Lizenzrisiken | Abweichende Lizenzbedingungen für virtualisierte Infrastruktur | Lizenzprüfung im Rahmen der Bewertung | Bevor ein Workload ausgewählt wird |
Die rechte Spalte verdeutlicht, warum Programme zur Kostenoptimierung nach einer Migration häufig hinter den Erwartungen zurückbleiben. Jede dieser Kontrollmaßnahmen lässt sich vor der Migration eines Workloads deutlich kostengünstiger implementieren als danach, und einige lassen sich im Nachhinein nur mit erheblichem Aufwand nachrüsten. Tagging ist das deutlichste Beispiel: Wird es bereits bei der Account-Erstellung eingeführt, verursacht es praktisch keinen zusätzlichen Aufwand. In einer bereits laufenden Umgebung muss dagegen anhand der Deployment-Historie und des Wissens von Mitarbeitern, die möglicherweise inzwischen das Team gewechselt haben, rekonstruiert werden, wem welche Ressource gehört.
Machen Sie Kosten-Governance zu einem festen Migrationsergebnis statt zu einem späteren Projekt.
Lift and Shift ist nicht der Fehler. Dabei stehen zu bleiben schon.
Für Rehosting gibt es gute Gründe, und die Kritik daran ist häufig ungerechtfertigt. Die Migration von Workloads mit minimalen Änderungen verkürzt das Migrationsfenster, reduziert die Anzahl gleichzeitig veränderter Faktoren und ermöglicht es einem Unternehmen, zunächst Erfahrungen mit AWS zu sammeln und die Kompetenzen aufzubauen, die für spätere Optimierungen erforderlich sind. Als erste Phase ist dieser Ansatz gut vertretbar und häufig die richtige Wahl.
Das Anti-Pattern besteht darin, Rehosting als Endzustand zu betrachten, obwohl im Budget Einsparungen eingeplant wurden, die erst durch Optimierung entstehen. Der dem Management präsentierte Business Case ging von einer modernisierten Kostenstruktur aus. Die tatsächlich umgesetzte Migration führte jedoch zu einer nicht modernisierten Umgebung auf verbrauchsabhängig abgerechneter Infrastruktur. Diese ist strukturell teurer als die ersetzte eigene Hardware, da zuvor kostenfreie Kapazitätsreserven nun stundenweise abgerechnet werden. Genau diese Differenz sollte durch die geplante Optimierungsphase geschlossen werden.
Diese Phase wird anschließend häufig gestrichen – und das ist vorhersehbar. Sie beginnt nach einem erfolgreichen Cutover, wenn das Unternehmen erschöpft, das Migrationsbudget aufgebraucht und das Infrastrukturteam mit einem über Monate aufgeschobenen Backlog beschäftigt ist. Optimierung wirkt wenig attraktiv, schafft keine unmittelbar sichtbaren neuen Funktionen und konkurriert mit Aufgaben, die klare geschäftliche Sponsoren haben. Wer diesen Ablauf mehrfach erlebt hat, betrachtet die Optimierungsphase daher nicht mehr als verlässlichen Plan, sondern lediglich als Absicht.
Modernisierung funktioniert am besten als kontrollierter Übergang und nicht als vollständiger Austausch auf einmal. Die Architektur kann schrittweise weiterentwickelt werden, während das Kundenerlebnis erhalten bleibt. Lesen Sie unsere Analyse zur Legacy-Modernisierung
Es gibt eine spezifischere Variante dieses Anti-Patterns, die gesondert betrachtet werden sollte, da sie schwieriger zu erkennen ist. Eine Migration kann technisch optimiert sein, mit korrekt dimensionierten Instanzen und sinnvoll konfiguriertem Speicher, und dennoch wirtschaftlich scheitern, wenn niemand für die Kostenprognose verantwortlich ist. Right-Sizing ist eine einmalige Maßnahme, Kosten-Governance dagegen ein kontinuierlicher Prozess. Eine zum Zeitpunkt des Cutovers korrekt konfigurierte Umgebung kann bereits innerhalb von zwei Quartalen von ihrem optimalen Zustand abweichen, wenn Teams neue Ressourcen bereitstellen. Entscheidend ist daher nicht nur die ursprüngliche Konfiguration, sondern eine regelmäßige Überprüfung, die Abweichungen erkennt, solange sie noch gering sind.
Die Kosten von Ausfallzeiten trägt letztlich derjenige, der den Cutover nicht ausreichend geplant hat
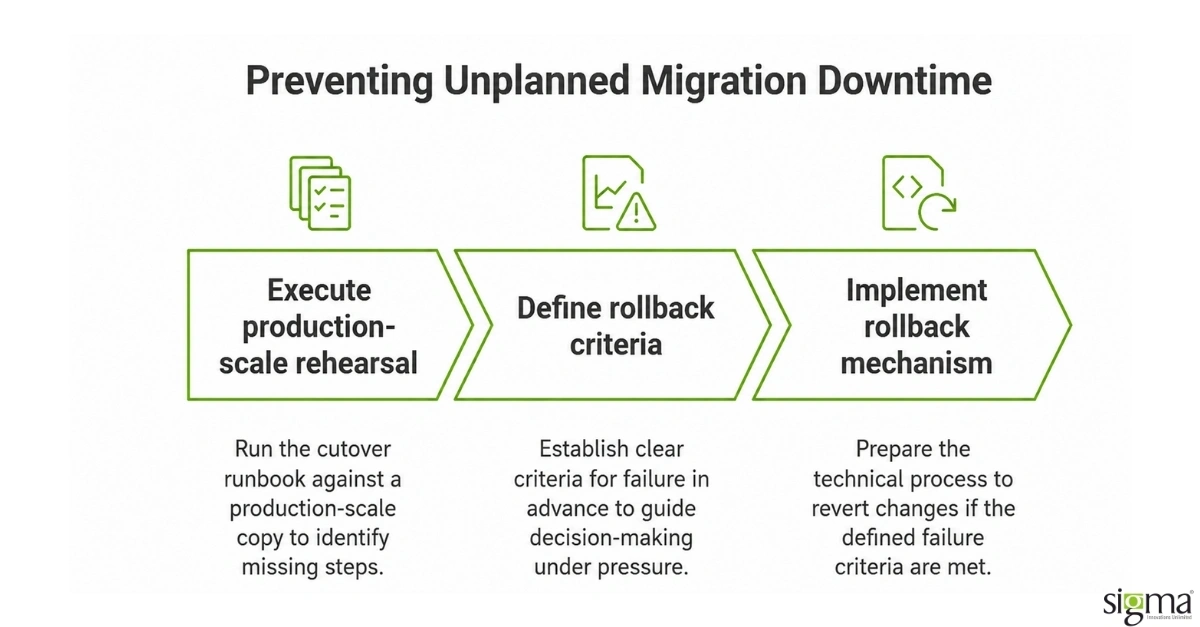
Ungeplante Ausfallzeiten während einer Migration verursachen erhebliche Kosten, die in einer nachträglichen Analyse häufig nicht vollständig sichtbar werden, da sie außerhalb des Technologiebudgets entstehen. Entgangene Umsätze, durch den Vorfall gebundene Supportkapazitäten, vertragliche Servicegutschriften und mögliche Reputationsschäden bei Enterprise-Kunden sind reale Auswirkungen, werden jedoch in der Regel nicht dem Migrationsprojekt zugerechnet.
Die Vermeidung solcher Ausfälle ist vor allem eine Frage realistischer Probeläufe und weniger des Designs. Ein Cutover-Runbook, das an einer produktionsnahen Kopie tatsächlich ausgeführt wurde, verhält sich anders als eines, das lediglich in einem Dokument geprüft wurde. Die Unterschiede zeigen sich häufig in Schritten, die niemand dokumentiert hat. Noch wichtiger als der eigentliche Rollback-Mechanismus ist die vorherige Definition klarer Rollback-Kriterien. Teams unter hohem Zeitdruck werden einen problematischen Cutover sonst möglicherweise weiterführen, wenn nicht im Voraus festgelegt wurde, wann ein Abbruch erforderlich ist.
Die Optimierungsphase, die niemals stattfindet
Im Migrationsplan wird die Optimierung häufig als Aufgabe nach dem Go-live eingeplant. Genau dann ist die Wahrscheinlichkeit jedoch am geringsten, dass sie tatsächlich umgesetzt wird. Das Migrationsbudget ist bereits aufgebraucht, das Infrastrukturteam konzentriert sich auf die Stabilisierung der neuen Umgebung und die Maßnahmen, die die versprochenen Einsparungen erzielen sollten, konkurrieren nun mit operativen Prioritäten.
Ein nachhaltigerer Ansatz integriert Kostenkontrollen von Beginn an in die Migrationsentscheidungen. Dazu gehören die Analyse der Workload-Auslastung vor einer Migrationswelle, die Berücksichtigung von Datenbewegungen und Speicherverhalten in der Zielarchitektur sowie die Festlegung klarer Verantwortlichkeiten, bevor Ressourcen bereitgestellt werden. Eine AWS-Migration wird damit nicht nur zu einem Wechsel zwischen Umgebungen, sondern auch zu einer Gelegenheit, festzulegen, wie die neue Umgebung anschließend betrieben wird.
Führen Sie Right-Sizing durch, bevor der Workload migriert wird
Der Ersatz eines On-Premises-Servers durch eine vergleichbare AWS-Instanz führt nicht zwangsläufig zu einer vergleichbaren Kostenstruktur. Die ursprüngliche Infrastruktur wurde möglicherweise für historische Lastspitzen, geplantes Wachstum oder schlicht deshalb großzügiger dimensioniert, weil zusätzliche Kapazität günstiger war als das Risiko einer Unterprovisionierung.
Die Migrationsplanung sollte daher tatsächliche Auslastungsdaten verwenden, um die Zielkonfiguration festzulegen. Vor jeder Migrationswelle können Workloads hinsichtlich Compute-, Speicher- und Performance-Anforderungen bewertet werden. Dadurch sinkt das Risiko, dass überdimensionierte Infrastruktur zum neuen Standard wird.
Auch hier spielt die Migrationsarchitektur eine entscheidende Rolle. Instanzauswahl, Speicherkonfiguration und Platzierung der Workloads sollten gemeinsam betrachtet werden, anstatt sie als voneinander unabhängige Infrastrukturentscheidungen zu behandeln.
Machen Sie klare Verantwortlichkeiten zur Regel bei der Ressourcenbereitstellung
Kostentransparenz wird schwierig, wenn niemand für die Ressourcen verantwortlich ist, die diese Kosten verursachen. Testumgebungen, temporäre Instanzen, Snapshots und duplizierte Infrastruktur können noch lange aktiv bleiben, nachdem das Projekt, für das sie erstellt wurden, bereits abgeschlossen ist.
Resource-Tagging und Richtlinien für Verantwortlichkeiten lassen sich kostengünstig etablieren, bevor Workloads migriert werden, sind im Nachhinein jedoch deutlich schwieriger zu rekonstruieren. Account-Struktur, Tagging-Standards und Provisioning-Kontrollen sollten daher als Bestandteil der Migrationsgrundlage eingerichtet werden, anstatt sie erst einzuführen, nachdem die Umgebung bereits gewachsen ist.
Behandeln Sie Datenbewegungen als Architekturentscheidung
Datenübertragungskosten werden häufig erst entdeckt, nachdem die Architektur bereits implementiert wurde. Datenverkehr zwischen Availability Zones, Regionen und externen Services kann wiederkehrende Kosten verursachen, die in der ursprünglichen On-Premises-Umgebung nicht vorhanden waren.
Die Migrationsplanung sollte diese Datenpfade vor dem Cutover analysieren. Anwendungsabhängigkeiten, Platzierung von Services, Speicherentscheidungen und Netzwerkarchitektur beeinflussen die daraus entstehende Kostenstruktur. Werden diese Aspekte im Rahmen der Workload-Bewertung berücksichtigt, lässt sich die Migrationsarchitektur gezielter planen und der Bedarf an kostspieligen Änderungen nach der Implementierung reduzieren.
Planen Sie Migrationswellen so, dass sich die Wirtschaftlichkeit überprüfen lässt
Migrationswellen sollten mehr bieten als lediglich einen Zeitplan für die Verlagerung von Anwendungen. Sie sollten Möglichkeiten schaffen, die Annahmen des Business Case anhand realer Ergebnisse zu überprüfen.
Workloads mit klaren Auslastungsmustern und wenigen Abhängigkeiten eignen sich gut als frühe Kandidaten, da sie messbare Erkenntnisse über den tatsächlichen AWS-Verbrauch liefern. Weicht die Prognose von der Realität ab, können Dimensionierung, Architektur oder Kostenannahmen angepasst werden, bevor komplexere Workloads migriert werden.
Dadurch wird die Planung von Migrationswellen zu einem Feedback-Mechanismus statt zu einer reinen Priorisierungsaufgabe.
Erkennen Sie, welche Workloads noch nicht migriert werden sollten
Ein Migrationsinventar bedeutet nicht, dass jeder Workload Teil der nächsten Migrationswelle sein muss. Eine Anwendung, die ohnehin ersetzt werden soll, ein Workload mit ungeklärten Lizenzbedingungen oder ein System ohne definierte Zielarchitektur sollte möglicherweise zunächst zurückgestellt werden.
Eine solche Entscheidung kann aus geschäftlicher Sicht unbequem sein. Einen Workload jedoch nur deshalb zu migrieren, weil er im Inventar aufgeführt ist, kann Kosten verursachen, ohne nachhaltigen Mehrwert zu schaffen. Eine fundierte AWS-Migrationsstrategie muss daher die Möglichkeit bieten, Workloads zu priorisieren, neu zu gestalten, außer Betrieb zu nehmen oder zurückzustellen, anstatt Migration als Verpflichtung zu betrachten, alles zu verschieben.
Binden Sie das Finanzteam in die Migration ein
Das Finanzteam sollte das AWS-Kostenmodell nicht erst kennenlernen, wenn die erste Produktionsrechnung eintrifft. Die Annahmen hinter den prognostizierten laufenden Kosten müssen während der Migration der Workloads überprüft werden, insbesondere wenn tatsächliche Auslastung, Datenübertragung, Speicherwachstum oder Lizenzbedingungen von der ursprünglichen Schätzung abweichen.
Der Vergleich von Prognose und tatsächlichem Verbrauch bei jeder Migrationswelle ermöglicht mehrere kleinere Korrekturen, anstatt das Unternehmen nach dem Go-live mit einer großen Kostenabweichung zu konfrontieren.
Das Ergebnis ist eine andere Definition von Migrationserfolg: Der Workload wurde migriert, die Architektur entspricht seinen tatsächlichen Anforderungen, Verantwortlichkeiten und Kostenkontrollen sind etabliert und das Unternehmen verfügt über einen Mechanismus, um die Umgebung dauerhaft mit den wirtschaftlichen Annahmen in Einklang zu halten, die die Migration ursprünglich gerechtfertigt haben.
Lesen Sie unsere Erfolgsgeschichte: Upgrade der Magento-Plattform und Implementierung einer Headless-Architektur für einen Kunden aus Ozeanien
Fazit
Eine AWS-Cloud-Migration die jeden Workload erfolgreich verschiebt, kann dennoch wirtschaftlich scheitern, wenn der Mechanismus zur Steuerung der Ausgaben bei der bisherigen Hardware zurückbleibt. Überprovisionierung, nutzungsabhängig abgerechnete Datenübertragung, verwaiste Ressourcen, Speicher ohne Lifecycle-Regeln und veränderte Lizenzbedingungen auf virtualisierter Infrastruktur erklären einen Großteil der Differenz zwischen prognostizierten und tatsächlichen Kosten. Rehosting ist als erste Phase gut vertretbar, wird jedoch zu einem kostspieligen Endzustand, wenn die für den Business Case erforderlichen Optimierungsmaßnahmen auf einen späteren Zeitpunkt verschoben werden, an dem dafür kein Budget mehr vorhanden ist. Während der Migration implementierte Kontrollen mit klar benannten Verantwortlichen und belastbaren Auslastungsdaten überstehen den Cutover deutlich zuverlässiger als ein nachträgliches Optimierungsprojekt. Unternehmen, die am Ende die prognostizierte Wirtschaftlichkeit erreichen, behandeln die Kostenfrage als Bestandteil der Migration und nicht als nachgelagertes Projekt.
Häufig gestellte Fragen
F1. Warum steigen die Kosten nach einer erfolgreichen AWS-Cloud-Migration?
A1. Weil der Genehmigungsmechanismus zusammen mit der bisherigen Hardware zurückgelassen wurde. On-Premises erforderte zusätzliche Kapazität eine Bestellung und einen Finanzprozess. Bei AWS kann jeder berechtigte Entwickler jederzeit über einen API-Aufruf zusätzliche Kapazität bereitstellen, während die daraus entstehenden Kosten möglicherweise erst Wochen später sichtbar werden. Die zuvor durch den Beschaffungsprozess gewährleistete Kontrolle wurde nicht ersetzt.
F2. Was sind die größten versteckten Kosten einer AWS-Migration?
A2. Fünf Faktoren verursachen den größten Teil der Differenz zwischen Prognose und tatsächlichen Kosten: unverändert von überdimensionierten Servern übernommene Instanzgrößen, nutzungsabhängig abgerechnete Datenübertragungen zwischen Availability Zones und Regionen, verwaiste Testressourcen, die nach Projektabschluss nicht bereinigt wurden, Logs und Backups in teuren Speicherklassen sowie kommerzielle Lizenzen mit abweichenden Bedingungen für virtualisierte Infrastruktur.
F3. Ist Lift and Shift ein Fehler?
A3. Rehosting ist als erste Phase gut vertretbar. Es verkürzt das Migrationsfenster und reduziert die Anzahl gleichzeitig veränderter Faktoren. Der Fehler besteht darin, es als Endzustand zu betrachten und gleichzeitig Einsparungen einzuplanen, die erst durch spätere Optimierungsmaßnahmen entstehen. Nach dem Cutover konkurriert diese Phase jedoch häufig mit anderen Prioritäten um das verfügbare Budget.
F4. Wann sollten Kontrollen für Cloud-Kosten eingeführt werden?
A4. Ausnahmslos bevor Workloads migriert werden. Resource-Tagging sollte bereits bei der Account-Einrichtung erfolgen, Right-Sizing während der Wellenplanung anhand tatsächlicher Auslastungsdaten statt reiner Hardwarespezifikationen, Aufbewahrungsregeln gemeinsam mit jedem Workload und die Lizenzprüfung im Rahmen der ersten Bewertung. Die nachträgliche Implementierung dieser Maßnahmen in einer laufenden Umgebung ist erheblich aufwendiger und kostspieliger.
F5. Wie lassen sich ungeplante Ausfallzeiten während eines Cutovers vermeiden?
A5. Realistische Probeläufe sind hier wichtiger als reine Planung. Ein Runbook, das tatsächlich an einer produktionsnahen Kopie ausgeführt wurde, verhält sich anders als eines, das lediglich auf dem Papier geprüft wurde. Besonders wichtig ist es, die Rollback-Kriterien im Voraus festzulegen, da Teams unter hohem Zeitdruck einen fehlschlagenden Cutover sonst möglicherweise weiterführen, wenn nicht vorher eindeutig definiert wurde, wann ein Abbruch erforderlich ist.