False Positives bei der Betrugserkennung sind ein Kostenproblem, kein Modellproblem
False Positives bei der Betrugserkennung sind ein Kostenproblem, kein Modellproblem False Positives bei der Betrugserkennung liegen genau in dieser Lücke und verursachen Verluste bei Umsatz, Servicekapazität und Kundenzufriedenheit, ohne jemals als eigener Kostenpunkt sichtbar zu werden. Ein Risikoteam kann den Recall um zwei Prozentpunkte erhöhen und gleichzeitig durch fälschlich abgelehnte legitime Kunden mehr Marge verlieren, als durch die zusätzliche Betrugsvermeidung eingespart wird. Die Position eines Schwellenwerts ist daher eine Kostenentscheidung, und viele Institute treffen sie auf Grundlage unvollständiger Kostendaten. Die gemeldeten Betrugsverluste in den USA beliefen sich 2025 auf rund 16 Milliarden US-Dollar. Genau dieser Druck führt dazu, dass Teams Kontrollen verschärfen, ohne die daraus entstehenden Folgekosten vollständig zu berücksichtigen.
Wichtige Highlights:
- Betrugsschwellenwerte werden häufig anhand der Erkennungsrate optimiert, sodass Umsatzverluste durch fälschlich abgelehnte legitime Kunden nicht in die Entscheidung einfließen.
- Bewerten Sie eine falsche Ablehnung und einen nicht erkannten Betrugsfall in derselben finanziellen Einheit und setzen Sie Schwellenwerte anhand der verfügbaren Review-Kapazität statt anhand eines Zielwerts für den Recall.
- Präzision wird dadurch zu einer budgetierbaren und nachvollziehbaren Kennzahl, die sowohl einer Managementprüfung als auch einer regulatorischen Prüfung standhält.
- Sigma entwickelt Betrugsmodelle unter Berücksichtigung der Kosten einer falschen Ablehnung und kombiniert sie mit Feature-Pipelines, Review-Tools und Drift-Monitoring, um diese Kosten dauerhaft unter Kontrolle zu halten.
Ein False Positive ist eine bewertete Entscheidung und kein rein technischer Fehler
Ein False Positive ist eine legitime Transaktion, ein legitimer Antrag oder ein legitimes Konto, das durch eine Betrugskontrolle blockiert oder zur manuellen Prüfung zurückgehalten wird. False Positives bei der Betrugserkennung werden im Allgemeinen als Modellfehler behandelt und als Rate ausgewiesen, wodurch Teams sie häufig als Qualitätsproblem der Data-Science-Funktion betrachten. Diese Sichtweise verschleiert jedoch, dass jeder fälschlich abgelehnte Kunde konkrete, berechenbare Kosten verursacht: die entgangene Marge der blockierten Transaktion, die Servicekosten der daraus entstehenden Beschwerde und die Wahrscheinlichkeit, dass der Kunde nicht zurückkehrt. Solange diese drei Werte nicht vorliegen, lässt sich ein Schwellenwert nicht rational festlegen. Er kann lediglich intuitiv begründet werden, was gegenüber einem Kreditausschuss keine belastbare Grundlage darstellt.
Risikoverantwortliche gehen häufig davon aus, dass die Gesamtkosten gering sind, weil jede einzelne Ablehnung nur einen kleinen Betrag betrifft. Entscheidend ist jedoch die Verteilung. Eine Kontrolle, die bei einem hochwertigen Kreditgeber ein Prozent des legitimen Volumens blockiert, trifft häufig gerade Kunden mit umfangreichen Kreditprofilen und hohen Salden, weil diese Profile ungewöhnliche Merkmale aufweisen, auf die die Regeln ursprünglich ausgerichtet wurden. Die False-Positive-Rate ist daher ein Durchschnittswert, der verschleiern kann, dass besonders wertvolle Kundenbeziehungen überproportional betroffen sind.
Mehr erfahren: Betrugserkennung im FinTech mit Machine Learning – Ansätze und Best Practices
Was False Positives bei der Betrugserkennung tatsächlich kosten
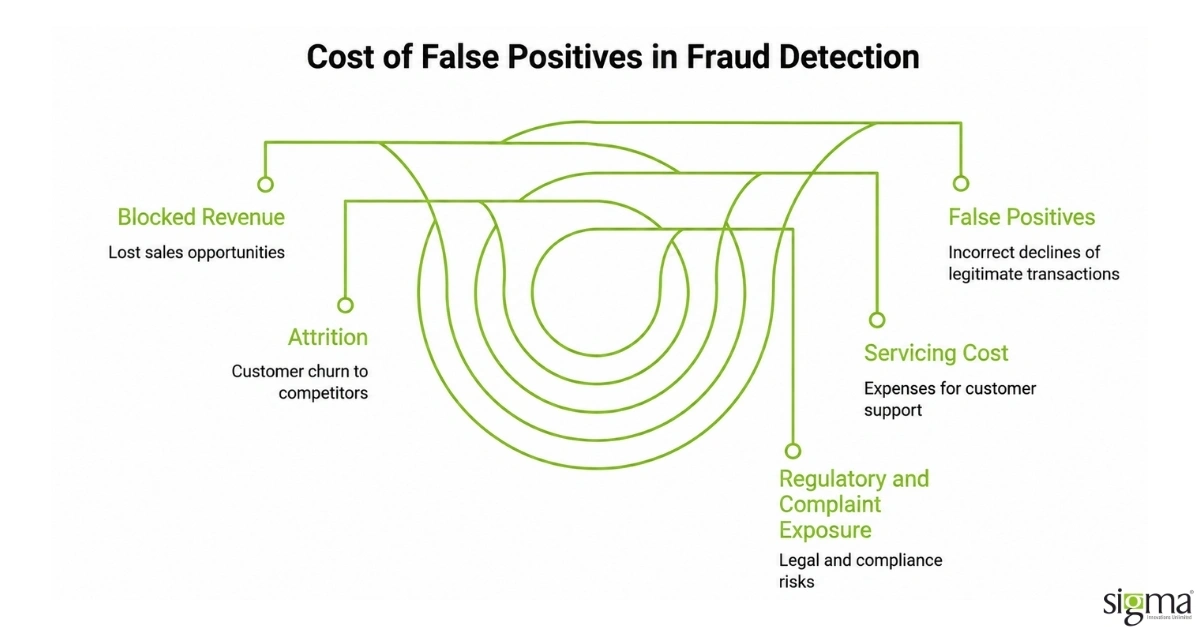
Die Kosten einer falschen Ablehnung lassen sich in vier Komponenten aufteilen, von denen meist nur die erste gemessen wird. Der entgangene Umsatz ist der sichtbarste Faktor und kann teilweise zurückgewonnen werden, wenn ein Kunde die Transaktion erneut versucht oder den Support kontaktiert. Der zweite Faktor sind Servicekosten für Kontaktaufnahme, manuelle Prüfung und Wiederfreigabe, die bei einer Supportfunktion anfallen, die den Schwellenwert nicht selbst festgelegt hat. Der dritte und bei großem Volumen größte Faktor ist Kundenabwanderung, da ein Kunde nach einer Ablehnung häufig denselben Kauf oder Antrag bei einem anderen Anbieter abschließt und dort bleibt. Der vierte Faktor ist das regulatorische und beschwerdebezogene Risiko, das deutlich zunimmt, wenn Ablehnungen mit geschützten Merkmalen korrelieren, selbst wenn diese Merkmale nicht direkt im Modell enthalten sind.
Institute, die alle vier Kostenkomponenten quantifizieren, stellen häufig fest, dass ihr optimaler Schwellenwert deutlich weniger streng ist als der aktuell verwendete. Dieses Ergebnis ist unangenehm, weil es zeigt, dass die aktuelle Konfiguration Betrugsreduzierung zu einem Preis erkauft, den das Unternehmen bewusst vermutlich nicht akzeptieren würde. Ein Kostenmodell vor der Anpassung der Entscheidungslogik zu erstellen, verwandelt die Diskussion zwischen Risiko- und Umsatzverantwortlichen in ein mathematisch lösbares Problem.
Die größte Hürde ist häufig die Verantwortung. Entgangener Umsatz liegt beim Commercial-Team, Servicekosten bei Operations, Kundenabwanderung beim Marketing und Beschwerderisiken bei Compliance. Dadurch verfügt keine einzelne Funktion über die vollständige Kostenbetrachtung und niemand ist allein für den Schwellenwert verantwortlich, der diese Kosten verursacht. Das Kostenmodell der Risikofunktion zuzuweisen und sie zu verpflichten, die übrigen Eingaben quartalsweise zu erfassen, ist eine Governance-Änderung und keine technische Maßnahme. Gleichzeitig beschleunigt sie jede spätere Anpassungsentscheidung, weil die Berechnungsgrundlage bereits feststeht, bevor die Diskussion beginnt.
Bewerten Sie Präzision mit einer belastbaren Kennzahl, bevor Sie den nächsten Schwellenwert anpassen.
Regelbasierte Systeme stoßen an Grenzen, weil sie Unsicherheit nicht bewerten können
Regelbasierte Systeme liefern eine binäre Entscheidung ohne Konfidenzwert. Genau deshalb lassen sie sich wirtschaftlich nur begrenzt optimieren. Eine Regel wird entweder ausgelöst oder nicht. Die einzigen verfügbaren Stellschrauben bestehen darin, Regeln hinzuzufügen, zu entfernen oder enger zu definieren. Jede Änderung beeinflusst Präzision und Recall gleichzeitig auf eine Weise, die vor dem Deployment kaum zuverlässig vorhersehbar ist.
Scoring-basierte Ansätze ordnen jeder Entscheidung eine Wahrscheinlichkeit zu, und eine Wahrscheinlichkeit kann mit Kosten multipliziert werden. Genau diese Eigenschaft ermöglicht überhaupt erst eine wirtschaftliche Festlegung von Schwellenwerten und ist das zentrale Argument für Machine-Learning-basierte Betrugserkennung gegenüber rein regelbasierten Kontrollen.
| Kriterium | Nur Regeln | Überwachtes Modell | Hybrid |
| Entscheidungsausgabe | Binäre Entscheidung | Wahrscheinlichkeitsscore | Score mit Regel-Overrides |
| Schwellenwertanpassung | Nicht verfügbar | Kontinuierlich und wirtschaftlich bewertbar | Kontinuierlich innerhalb definierter Richtliniengrenzen |
| Reaktion auf neue Angriffsmuster | Manuelle Erstellung neuer Regeln | Retraining und Drift-Signale | Regeln überbrücken die Lücke, während das Modell neu trainiert wird. |
| Belastung der Review-Warteschlange | Durch den Umfang der Regeln festgelegt | An die verfügbare Kapazität anpassbar | Anpassbar mit festen Richtliniengrenzen |
| Erklärbarkeit | Direkt und inhärent | Erfordert Attributions-Tools | Direkt bei Overrides, attributbasiert bei Scores |
| Änderungskosten | Gering pro Regel, in der Summe jedoch hoch | Hoher Implementierungsaufwand, geringe Anpassungskosten | Hoher Implementierungsaufwand, geringe Anpassungskosten |
Das Problem der zunehmenden Regelmenge verdient besondere Aufmerksamkeit. Neue Regeln lassen sich kostengünstig hinzufügen, sind jedoch organisatorisch schwierig zu entfernen, weil dafür jemand offiziell erklären müsste, dass eine bestimmte Verlustkategorie nun akzeptiert wird. Ein ausgereiftes Regelwerk wächst daher häufig über Jahre hinweg. Wechselwirkungen zwischen Regeln, die zu unterschiedlichen Zeitpunkten von verschiedenen Personen erstellt wurden, führen zu Ablehnungen, die niemand beabsichtigt hat und kaum nachvollziehbar sind. Institute mit mehreren Hundert aktiven Regeln können häufig nicht mehr eindeutig sagen, welche Regeln noch einen wirtschaftlichen Nutzen liefern. Dadurch ist eine wirtschaftliche Bewertung des aktuellen Schwellenwerts kaum möglich, bevor das Regelwerk bereinigt wurde.
Die meisten regulierten Institute entscheiden sich letztlich für einen hybriden Ansatz, und der Grund dafür ist selten eine rein technische Präferenz. Bestimmte Ablehnungen müssen aus Richtlinien- oder Sanktionsgründen unabhängig vom Modellscore erfolgen. Daher bleibt eine Regelbasis als verbindliche Mindestkontrolle bestehen, während das Modell die wirtschaftlich flexibel steuerbaren Entscheidungen darüber übernimmt.
Die Präzision wird durch die Review-Warteschlange bestimmt, nicht allein durch das Modell
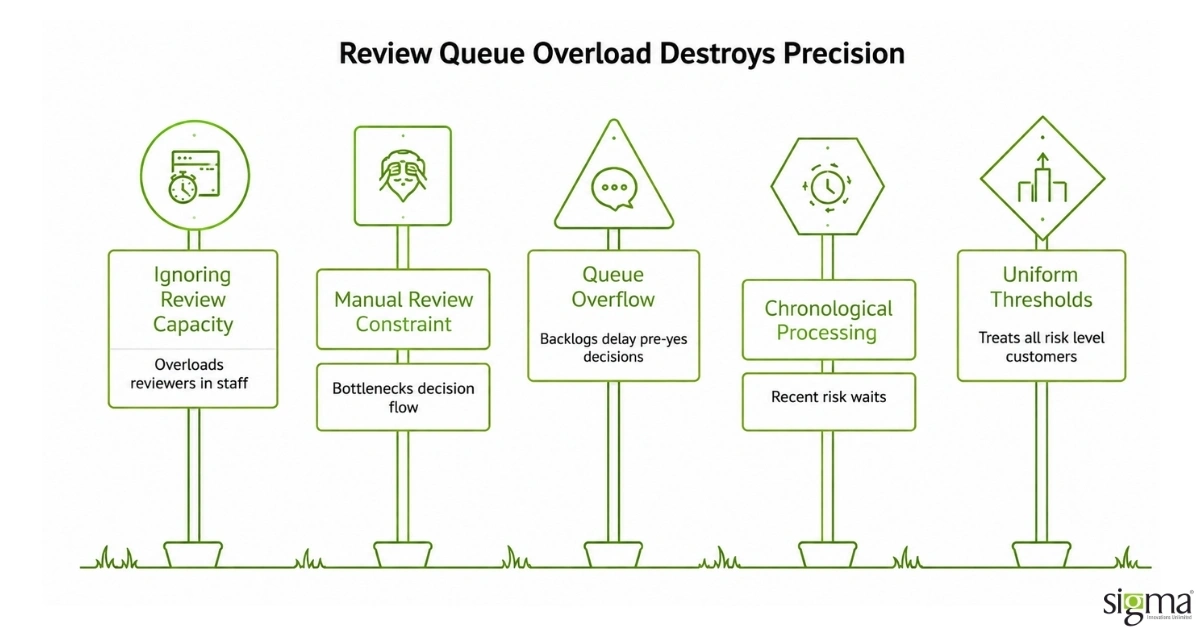
Ein Betrugsschwellenwert, der die verfügbare Review-Kapazität ignoriert, wird innerhalb kurzer Zeit von den Mitarbeitern der Warteschlange praktisch außer Kraft gesetzt. Manuelle Prüfung ist in den meisten Programmen der tatsächliche Engpass: Das Modell erzeugt eine bestimmte Anzahl zurückgehaltener Fälle, während ein begrenztes Team entscheidet, wie viele davon bearbeitet werden können, bevor das Service-Level nicht mehr eingehalten wird. Wenn die Warteschlange überläuft, beginnen Analysten, Fälle schneller abzuarbeiten, um den Backlog zu reduzieren. Dadurch sinkt genau die Präzision, die der Schwellenwert eigentlich sicherstellen sollte, während die gemeldeten Kennzahlen unverändert bleiben.
Ein Design entlang des tatsächlichen Engpasses bedeutet, die Kapazität der Warteschlange als Eingabe für die Auswahl des Schwellenwerts zu behandeln und nicht als nachgelagerte Folge. Priorisierung ist dabei entscheidend: Werden zurückgehaltene Fälle nach erwarteter Verlusthöhe sortiert, kann ein gleich großes Team deutlich mehr wirtschaftlichen Wert sichern als bei einer rein chronologischen Bearbeitung. Segmentbasierte Schwellenwerte ergänzen diesen Ansatz, denn ein Neukunde ohne Historie und ein langjähriger Kunde mit vier Jahren unauffälligem Verhalten sollten nicht denselben Score-Grenzwert erhalten.
Die Ergebnisse der Review-Warteschlange sollten außerdem wieder in das Modell zurückfließen, was in vielen Programmen jedoch nicht geschieht. Die Entscheidungen der Analysten sind für Grenzfälle die beste verfügbare Form gelabelter Ground-Truth-Daten, da sie eine menschliche Bewertung genau der Fälle darstellen, mit denen das Modell die größten Schwierigkeiten hatte. Werden diese Entscheidungen strukturiert und mit Begründung statt nur mit einem einfachen Freigabe- oder Betrugsflag erfasst, erhält der nächste Trainingszyklus Informationen, die aus keiner anderen Quelle verfügbar sind. Programme, die dieses Signal verwerfen, trainieren erneut auf den einfacheren Fällen und wundern sich anschließend, warum sich die Präzision an der Entscheidungsgrenze nicht verbessert.
Schwellenwerte optimieren, wenn jede Entscheidung einer Prüfung standhalten muss
Die größte Herausforderung bei regulierter Betrugserkennung ist nicht die Genauigkeit. Entscheidend ist, dass jede automatisierte Ablehnung auch Monate später gegenüber einer Aufsichtsbehörde erklärbar und reproduzierbar sein muss. Dabei muss nachvollziehbar sein, warum ein Antragsteller abgelehnt wurde und welche Signale das Modell berücksichtigt hat. Diese Anforderung schließt viele Methoden aus, die Modelle in unregulierten Umgebungen besonders leistungsfähig machen. Intransparente Feature-Interaktionen, nicht protokollierte Drittanbietersignale und unbemerktes Retraining können die gemessene Performance verbessern, bestehen jedoch keine regulatorische Prüfung. Sigma entwickelt daher zunächst entlang dieser Anforderung, denn ein Modell, das nicht verteidigt werden kann, ist weniger wert als ein Regelwerk, das nachvollziehbar bleibt.
In der Praxis beeinflusst dies die technische Umsetzung sehr konkret. Feature-Pipelines werden versioniert, sodass die exakten Eingabedaten jeder historischen Entscheidung rekonstruiert werden können. Dies ist besonders wichtig, wenn eine Beschwerde oder Prüfung erst acht Monate später erfolgt.
Scoring wird von Richtlinienlogik getrennt, sodass Sanktions- und regulatorisch bedingte Ablehnungen als auditierbare Regeln ausgeführt werden, anstatt in einer Wahrscheinlichkeit aufzugehen, die anschließend erklärt werden muss. Retraining erfolgt über Champion-Challenger-Validierung anhand von Live-Traffic, sodass Verbesserungen der Genauigkeit geprüft werden, bevor sie kundenrelevante Entscheidungen beeinflussen. Drift-Monitoring überwacht sowohl die Eingabeverteilung als auch die Modellausgabe, da schleichende Veränderungen eines Features im vorgelagerten Datenfluss häufig der Grund dafür sind, dass ein im März optimaler Schwellenwert im September plötzlich hohe Kosten verursacht.
Sigmas FinTech-Daten- und Analysearbeit umfasst auch die unterstützende Ebene, die darüber entscheidet, ob dieser Ansatz langfristig funktioniert: Anomalieerkennung, Device Intelligence und prädiktives Fraud Scoring speisen einen Echtzeit-Entscheidungspfad. Die Review-Tools sind dabei ebenso wichtig wie das Modell selbst, denn ein Case-Management-System, das zurückgehaltene Fälle mit den erforderlichen Nachweisen an die richtige Warteschlange weiterleitet, ermöglicht es einem festen Team, mit der vom Schwellenwert vorgesehenen Präzision zu arbeiten. Sigma betrachtet dies als kontinuierliche Zusammenarbeit und nicht als einmalige Lieferung, da ein Betrugssystem ohne regelmäßige Neukalibrierung zu einer Betrugserkennungssoftware mit zunehmendem Risiko wird – ungefähr in dem Tempo, in dem sich Angriffsmuster verändern.
Die folgenden Lending-Projekte zeigen die Origination- und Decisioning-Grundlage, auf der diese Arbeit aufbaut.
Erfahren Sie, wie ein automatisierter Entscheidungsprozess innerhalb eines laufenden Hypothekenbetriebs neu aufgebaut wurde. Lesen Sie die Erfolgsgeschichte zur Modernisierung des Hypothekengeschäfts
Servicing und Collections unterliegen nach einer Entscheidung denselben Anforderungen an Nachvollziehbarkeit und Auditierbarkeit. Diese Anforderungen setzen sich über den gesamten Kreditlebenszyklus fort und enden nicht mit der Origination.
Erfahren Sie, was für ein vollständig auditierbares Loan-Management-System erforderlich ist. Lesen Sie die Erfolgsgeschichte zum Loan-Management-System
Fazit
False Positives bei der Betrugserkennung sind eine wirtschaftliche Größe, die von vielen Instituten jedoch wie ein rein technisches Problem behandelt wird. Genau deshalb verschieben sich Schwellenwerte häufig in Richtung übermäßiger Vorsicht und bleiben dort. Werden die Kosten einer falschen Ablehnung und eines nicht erkannten Betrugs in derselben finanziellen Einheit bewertet, wird aus einem schwer lösbaren Konflikt zwischen Risiko und Umsatz eine Berechnung, die das Unternehmen tatsächlich entscheiden kann.
Scoring-basierte Entscheidungsmodelle ermöglichen diese Berechnung, da nur eine Wahrscheinlichkeit mit einem Kostenwert multipliziert werden kann und nur eine wirtschaftlich bewertete Entscheidung gegenüber dem Management belastbar begründet werden kann. Die Review-Kapazität setzt anschließend die praktische Obergrenze, denn ein Schwellenwert, dessen Fallvolumen die Warteschlange nicht bewältigen kann, wird in der Praxis von den Mitarbeitern korrigiert. Regulierte Institute müssen zusätzlich sicherstellen, dass jede dieser Entscheidungen auch lange nach ihrer Entstehung nachvollziehbar und erklärbar bleibt.
Bremst Legacy-Technologie Ihr Wachstum?
Häufig gestellte Fragen
F1. Was ist ein False Positive bei der Betrugserkennung?
A1. Ein False Positive ist ein legitimer Kunde, eine legitime Transaktion oder ein legitimer Antrag, der durch eine Betrugskontrolle blockiert oder zur manuellen Prüfung zurückgehalten wird. Üblicherweise wird dies als Rate im Verhältnis zum gesamten legitimen Volumen gemessen. Jeder False Positive verursacht entgangenen Umsatz, Servicekosten und ein reales Risiko, den Kunden dauerhaft zu verlieren.
F2. Wie berechnet man die Kosten eines False Positive?
A2. Vier Werte sollten kombiniert werden: die Marge der blockierten Transaktion, die Servicekosten für Beschwerde und Prüfung, der erwartete Wertverlust, wenn der Kunde nicht zurückkehrt, sowie mögliche Beschwerde- oder regulatorische Risiken. Da diese Werte unterschiedlichen Funktionen zugeordnet sind, sollte das Risikoteam alle vier quartalsweise erfassen und aktualisieren.
F3. Warum können Machine-Learning-Modelle False Positives besser steuern als regelbasierte Systeme?
A3. Regeln liefern lediglich eine binäre Entscheidung ohne Konfidenzwert und lassen sich deshalb wirtschaftlich nur begrenzt optimieren. Ein Scoring-Modell liefert dagegen eine Wahrscheinlichkeit, die mit einem Kostenwert multipliziert werden kann. Dadurch lassen sich Schwellenwerte anhand eines tatsächlichen finanziellen Trade-offs festlegen, anstatt sie rein intuitiv anzupassen.
F4. Welche False-Positive-Rate sollte ein Kreditgeber anstreben?
A4. Es gibt keinen universell richtigen Zielwert, da die optimale Rate von der Marge pro genehmigtem Kunden, der verfügbaren Review-Kapazität und den Kosten eines nicht erkannten Betrugs abhängt. Institute, die alle drei Faktoren wirtschaftlich bewerten, stellen häufig fest, dass der optimale Schwellenwert weniger streng ist als der aktuell verwendete – insbesondere bei hochwertigen Kundensegmenten.
F5. Wie häufig sollten Schwellenwerte für die Betrugserkennung neu kalibriert werden?
A5. Die Neukalibrierung sollte sich an Input Drift und nicht ausschließlich am Kalender orientieren. Sowohl Feature-Verteilungen als auch Score-Ausgaben sollten kontinuierlich überwacht werden. Die meisten regulierten Programme führen zusätzlich eine geplante vierteljährliche Überprüfung der wirtschaftlichen Schwellenwertlogik durch, da sich Marge, Review-Kapazität und Angriffsmuster innerhalb eines Quartals ausreichend verändern können, um den optimalen Schwellenwert zu verschieben.